Der Befund: nützliche Beobachtungen, kein öffentlich benannter Sieger
Weblaws AI Legal Research Challenge ist ein nützlicher Ausgangspunkt für eine Schweizer Rechts-KI-Evaluation. Die neun verfügbaren Folien der Veranstalterseite liefern keine öffentlich rekonstruierbare Anbieterrangliste. Ergebnisspalten sind anonym. Deshalb können wir weder sagen, Silex habe Omnilex geschlagen, noch Lawsearch AI habe Jurata geschlagen. [1] [2] [3] [4]
Wir haben sichtbare Beobachtungen in CSV und JSON übertragen. Sie enthalten 98 Einträge auf Zellebene zu 14 angezeigten Kennzahlen einschliesslich ausdrücklich als «nicht offengelegt» markierter Einträge. Es gibt keine zugewiesenen Anbieteridentitäten, Gesamtwerte oder geschätzten Werte für fehlende Angaben. Das sind Beobachtungen öffentlicher Folien, keine von Whisperit erzeugten Testergebnisse.
Praktisch sollten Sie Begründung und Quellenfassung prüfen, nachdem ein Werkzeug den scheinbar richtigen Entscheid findet. Auffinden ist ein notwendiger Anfang, nicht der gesamte Massstab verlässlicher anwaltlicher Arbeit.
Veröffentlichte Challenge-Folie
Vor den Ergebnissen die Challenge-Methode lesen
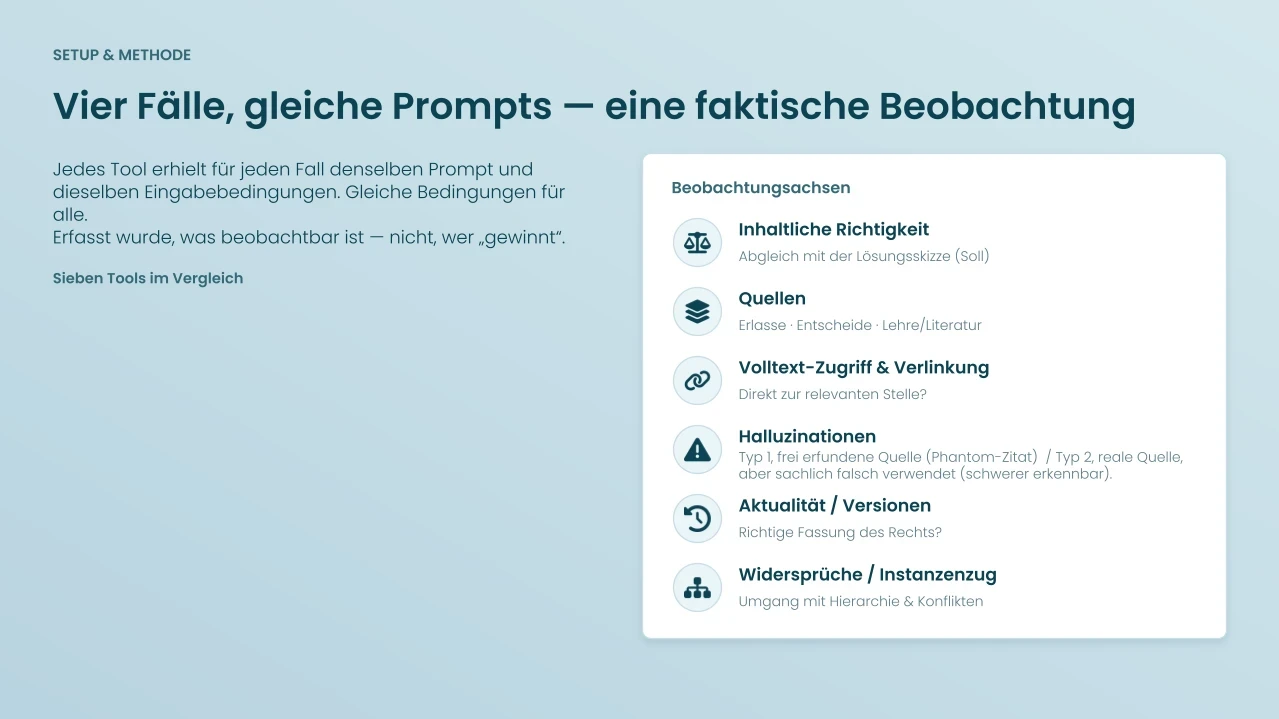
Weblaws Originalfolie beschreibt Richtigkeit, Quellen, Volltextzugriff, Halluzinationen, Aktualität und Widersprüche. Sie erläutert eine begrenzte Beobachtung; sie identifiziert keine anonymen Ergebnisspalten und bestimmt keinen Gesamtsieger.
Quelle: Weblaw · AI Legal Research Challenge, Folie 2
Bild in voller Grösse öffnenWas getestet wurde
Die Challenge fand am 17. Juni 2026 statt. Teilnehmer waren Silex, Omnilex, Jurata, Unplex, Libra, Lawsearch AI und ein Opus-Modell mit OpenCaseLaw. Laut Weblaw erhielten alle für jeden der vier Fälle dieselben Prompts und Eingabebedingungen. [5] [1]
Die öffentliche Methode verwendet sechs Achsen: inhaltliche Richtigkeit, Quellen, Volltextzugang und Verknüpfung, Halluzinationen, anwendbare Gesetzesfassungen sowie Umgang mit Widersprüchen oder Gerichtshierarchie. Sie unterscheidet erfundenes Zitat von falsch verwendeter existierender Quelle. Dies ist hilfreicher als der autoritative Klang einer Antwort. [6]
Die Szenarien betreffen Fahrlehrerbewilligung, Gläubiger-/Aktionärslegitimation im Schuldbetreibungsumfeld, Dashcam-Beweise und Datenschutz sowie Berner Sozialhilfe. Beschreibungen und erwartete Antworten stammen vom Veranstalter. Wir analysieren die veröffentlichte Evaluation und bestätigen die Rechtsantworten nicht unabhängig. [7] [8] [9] [10]
Die sichtbaren Ergebnisse zusammengetragen
| Öffentliches Ergebnis | Was die Folie zeigt | Was sie nicht belegt |
|---|---|---|
| Fall 1: erwarteter Entscheid 2C_149/2024 | In 7 von 7 anonymen Spalten vorhanden | Gleiche Begründungsqualität oder Volltextprüfung |
| Fall 1: zusätzlicher Entscheid 2C_131/2023 | In 1 von 7 Spalten vorhanden | Verbesserung der Antwort durch Zusatzentscheid |
| Fall 1: Literatur | In 4 von 7 Spalten vorhanden | Aussagekraft, Lizenz oder richtige Verwendung |
| Fall 2: Art. 298(2) SchKG | In 7 von 7 Spalten vorhanden | Richtige Legitimationsanalyse in jeder Antwort |
| Fall 2: erwarteter Entscheid 5A_53/2026 | In 6 von 7 Spalten vorhanden | Welches benannte Produkt ihn ausliess |
| Fall 2: Literatur / Nichtigkeitsfrage | Je in 4 von 7 Spalten vorhanden | Generell bessere längere oder breitere Antworten |
| Fall 3: BGE 146 IV 226 | In 7 von 7 Spalten vorhanden | Richtiger Umgang mit historischer Gesetzesfassung |
| Fall 3: erwartete Antwort getroffen | 6 vollständig, 1 teilweise | Allgemeine Genauigkeitsrate eines Anbieters |
| Fall 3: Literatur | In 3 von 7 Spalten vorhanden | Vergleichende Qualitätswertung |
Die Quellen sind die Matrizen auf den Folien 5, 7 und 9. Die Positionen wurden auf jeder Folie von links nach rechts übertragen. Wir haben nicht festgestellt, dass dieselbe Position über Fälle denselben Anbieter bezeichnet; der Datensatz darf deshalb nicht zu einer Anbieterbewertung zusammengeführt werden. [2] [3] [4]
Folie 5 zeigt «X» beim numerischen Gesetzesanzahlfeld. Wir bewahren es als nicht offengelegt, statt sechs oder keine Gesetze abzuleiten. Antwortlängenfelder auf Folien 5 und 9 sind leer. Sie bleiben als fehlende Angaben erfasst und werden nicht zu Antworten mit null Wörtern. Erratene scheinbare Vollständigkeit würde den Vergleich weniger vertrauenswürdig machen.
Ein Unterschied, den die breite Zusammenfassung verbergen kann
Weblaws Darstellung beschreibt allgemein starke Übereinstimmung mit erwarteten Lösungen und gefundene relevante Leitentscheide. Die Matrix zu Fall zwei ist konkreter: Eine anonyme Spalte zitiert den erwarteten Entscheid nicht. Erhalten Sie diesen Unterschied, statt zu behaupten, jedes Werkzeug habe jeden Leitentscheid gefunden. [1] [3]
Die Darstellung berichtet auch eine Halluzination des definierten ersten Typs im Dashcam-Fall beim Vermischen alten und neuen Datenschutzrechts sowie keine des zweiten Typs über die Challenge. Das sind vom Veranstalter berichtete Befunde zu vier Fällen. Sie belegen weder fehlerfreie Produkte noch Fehlerhäufigkeit in Kanzleiarbeit. Die Matrizen identifizieren den Anbieter des berichteten Fehlers nicht. [1]
Beim Dashcam-Szenario nennt die Erwartungsfolie die alte Gesetzesfassung als relevant. Folie 9 verweist für detaillierte Versionsunterschiede auf die nächste Folie. Diese liegt ausserhalb des öffentlichen Neun-Folien-Auszuges. Deshalb nennen wir keine Anzahl korrekt behandelnder Produkte. [10] [4]
Welches Gewicht sollten Käufer diesen Belegen geben?
Es ist ein echter, eng gefasster Vergleich des Veranstalters, der mehr aufgabenbezogene Belege bietet als eine reine Funktionsliste. Es ist zugleich eine begrenzte Momentaufnahme vom Juni; Weblaw betreibt Teilnehmer Lawsearch AI. Wir kennzeichnen die Geschäftsbeziehung, weil Veranstaltervergleich und unabhängiger vollständig reproduzierbarer Benchmark unterschiedlichen Belegstatus haben.
Das Deckblatt sagt, nicht alle Eingeladenen hätten teilgenommen und ein Herausforderer habe die Wiedergabe seiner Ergebnisse abgelehnt. Es nennt keinen Namen. Leiten Sie die Identität weder aus Logoreihenfolge noch anonymen Spalten oder Konkurrenzwerbung ab. [5]
Die vollständige Evaluation wird kostenlos auf Anfrage angeboten. Wir nutzten den öffentlichen Auszug und erhielten weder Bericht noch vollständige Ausgaben. Anbieterbezogene Ergebnisse, vollständige Befunde zu Fall vier und ausreichende Dokumentation zur Wiederholung des Tests bleiben diesem Entwurf deshalb unzugänglich. Eine Aktualisierung sollte Originaldatum und neue Belege vom Auszug unterscheiden. [1]
Whisperit, Swiss-Noxtua, CASUS und DeepJudge sind keine benannten Teilnehmer. Sie wurden in dieser Gruppe nicht bewertet; das bedeutet weder null Punkte noch schlechte Leistung oder einen bestimmten Ausschlussgrund.
Aus der Challenge einen besseren Test machen
Jeder Kandidat bearbeitet ein Mandat mit bekannter historischer Rechtsfrage. Verlangen Sie Datum, Fassung und Übergangsbegründung ausdrücklich. Ergänzen Sie entgegenstehende Rechtsquelle und prüfen Sie Schlussfolgerungsänderung. Lassen Sie eine Tatsache absichtlich fehlen und belohnen Sie Nachfrage oder Einschränkung.
Öffnen Sie für jede wesentliche Aussage die zitierte Passage und dokumentieren Sie deren Belegkraft. Trennen Sie «Quelle existiert», «Quelle ist relevant» und «Quelle beweist die Aussage». Erstellen Sie dann das benötigte Lieferdokument und lassen Sie eine andere Anwältin verifizieren.
Der gesamte Arbeitsablauf wurde durch die Challenge-Matrizen nicht belegt. Diktat, Quellenabonnements, Bearbeitung, Vertraulichkeitsarchitektur, Kollegenübergabe und Kosten brauchen eigene Belege. Unser leeres Evaluationsarbeitsblatt ergänzt dies, ohne Messung im Weblaw-Ereignis vorzutäuschen.
Nutzen Sie die Marktübersicht Schweizer Rechts-KI für Kategorien und aktuelle Produktunterschiede. Der Leitfaden zu Schweizer Recherchewerkzeugen liefert quellenbasierte Auswahl ohne benannten Matrixsieger.
Häufig gestellte Fragen
Welches Produkt gewann Weblaws Challenge?
Das öffentliche Material belegt keinen benannten Sieger. Wir ordnen anonymen Spalten keine Anbieternamen zu und erfinden aus der Teilnehmerliste keine Rangfolge.
Sind die herunterladbaren Daten ein unabhängiger Benchmark?
Nein. Es ist Whisperits Übertragung sichtbarer Fakten aus Weblaws Folien mit erhaltenen Herkunftsangaben und fehlenden Werten. Die Quellenbilder bleiben bei Weblaw verlinkt; wir veröffentlichen das Foliendeck nicht erneut.
Warum keine Prozentsätze oder Gesamtwertung berechnen?
Ein bestimmter Entscheid in sechs Spalten ist keine allgemeine 6/7-Produktgenauigkeit. Kennzahlen unterscheiden sich zudem im Gewicht und einige Daten fehlen. Eine Gesamtwertung würde diese Grenzen verbergen und einen Vergleich nahelegen, den die öffentlichen Belege nicht tragen.
Romain de Wolff


