Il risultato: osservazioni utili, nessun vincitore pubblico nominato
L'AI Legal Research Challenge Weblaw è un punto iniziale utile per valutare l'IA svizzera. Non offre una classifica dei fornitori ricostruibile pubblicamente nelle nove slide dell'organizzatore. Le colonne sono anonime. Non possiamo usarle per dire che Silex supera Omnilex o Lawsearch AI supera Jurata. [1] [2] [3] [4]
Abbiamo trascritto le osservazioni visibili in CSV e JSON. Contengono 98 registrazioni a livello di cella su 14 metriche mostrate, incluse voci «non divulgato». Nessuna identità assegnata, punteggio composito o stima mancante. Sono osservazioni da slide pubbliche, non risultati di prove prodotte da Whisperit.
La lezione pratica è verificare ragionamento e versione della fonte dopo aver trovato la decisione apparentemente giusta. Recuperarla è un inizio necessario, non l'intero standard del lavoro affidabile.
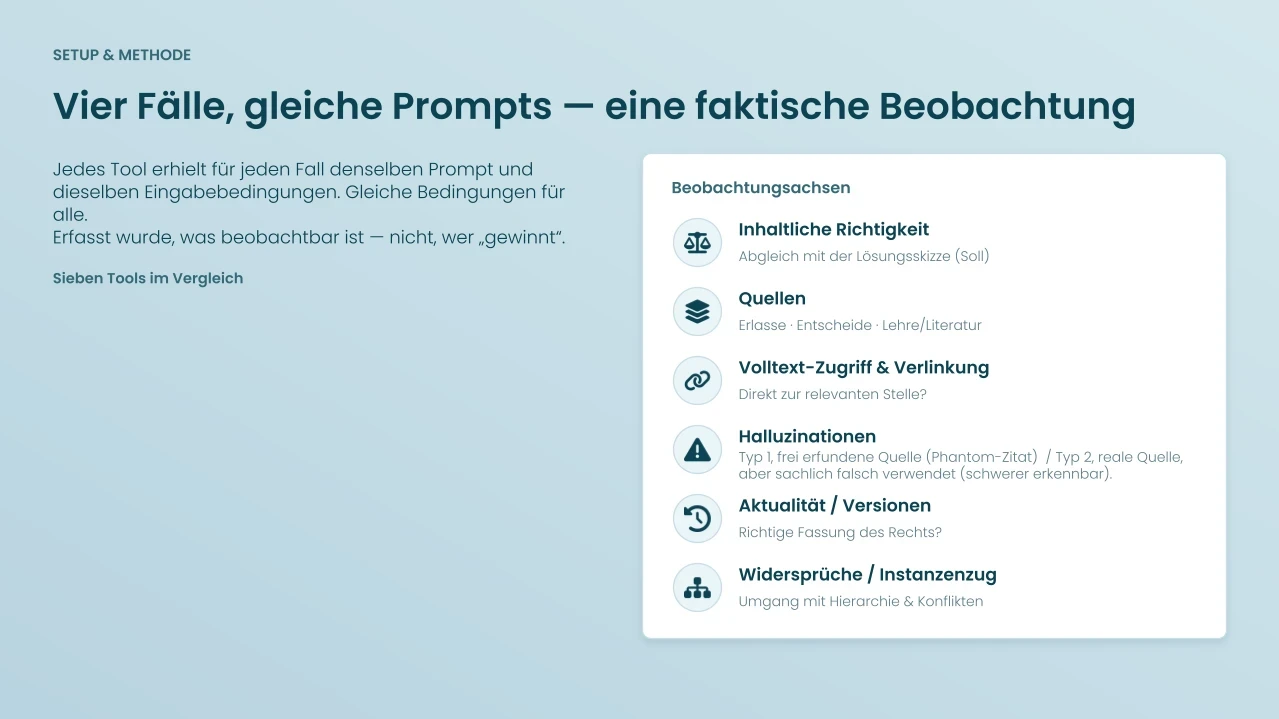
Diapositiva pubblicata della challenge
Leggere il metodo della challenge prima dei risultati
La diapositiva originale di Weblaw descrive correttezza, fonti, accesso al testo integrale, allucinazioni, aggiornamento e contraddizioni. Illustra un’osservazione limitata; non identifica le colonne anonime dei risultati né stabilisce un vincitore complessivo.
Fonte: Weblaw · AI Legal Research Challenge, diapositiva 2
Aprire l’immagine a grandezza naturaleCosa è stato provato
La challenge si è svolta il 17 giugno 2026. Partecipavano Silex, Omnilex, Jurata, Unplex, Libra, Lawsearch AI e un modello Opus con OpenCaseLaw. Secondo Weblaw, ciascuno riceveva stesso prompt e condizioni per ognuno dei quattro casi. [5] [1]
La metodologia pubblica usa sei assi: correttezza sostanziale, fonti, accesso e collegamenti integrali, allucinazioni, versioni legislative applicabili e contraddizioni o gerarchia giudiziaria. Distingue citazione inventata e fonte esistente usata male. Sono assi più utili del suono autorevole della risposta. [6]
I casi riguardano autorizzazione di un maestro conducente, legittimazione di creditore/azionista in esecuzione per debiti, prove dashcam e protezione dei dati, assistenza sociale bernese. Descrizioni e risposte attese provengono dall'organizzatore. Analizziamo la valutazione pubblicata senza avallare indipendentemente soluzioni giuridiche. [7] [8] [9] [10]
Risultati visibili raccolti
| Risultato pubblico | Cosa mostra la slide | Cosa non accerta |
|---|---|---|
| Caso 1: decisione attesa 2C_149/2024 | Presente in 7 colonne anonime su 7 | Uguale ragionamento o verifica integrale |
| Caso 1: ulteriore 2C_131/2023 | Presente in 1 su 7 | Che la citazione aggiuntiva migliori la risposta |
| Caso 1: letteratura | Presente in 4 su 7 | Autorevolezza, licenza o uso corretto |
| Caso 2: Art. 298(2) SchKG | Presente in 7 su 7 | Corretta legittimazione in ogni risposta |
| Caso 2: decisione attesa 5A_53/2026 | Presente in 6 su 7 | Quale prodotto nominato l'ha omessa |
| Caso 2: letteratura / nullità | Ciascuna presente in 4 su 7 | Che risposte più lunghe o ampie siano migliori |
| Caso 3: BGE 146 IV 226 | Presente in 7 su 7 | Corretta versione legislativa storica |
| Caso 3: accordo con risposta attesa | 6 pienamente, 1 parzialmente | Accuratezza generale di un fornitore |
| Caso 3: letteratura | Presente in 3 su 7 | Punteggio comparativo di qualità |
Matrici fonte: slide 5, 7 e 9. Posizioni trascritte da sinistra a destra in ogni slide. Non abbiamo accertato identità stabile del fornitore fra casi; non unite il dataset in punteggi per fornitore. [2] [3] [4]
La slide 5 mostra «X» nel campo numerico del numero di disposizioni. Lo conserviamo come non divulgato, senza interpretare sei disposizioni o nessuna. I campi lunghezza nelle slide 5 e 9 sono vuoti. Restano valori mancanti, non risposte di zero parole. Indovinare per sembrare completi renderebbe meno affidabile il confronto.
Una distinzione nascosta dalla sintesi generale
Il resoconto Weblaw descrive ampiamente accordo forte e decisioni pertinenti trovate. La matrice del secondo caso è più precisa: una colonna non cita la decisione attesa. Conservate la differenza senza affermare che tutti hanno trovato ogni decisione. [1] [3]
Il resoconto riferisce anche un'allucinazione del primo tipo definito nel caso dashcam, mescolando vecchio e nuovo diritto dei dati, e nessuna del secondo tipo nella challenge. Sono risultati riferiti dall'organizzatore su quattro casi. Non accertano un prodotto senza errori né prevedono frequenze nella pratica. Le matrici non identificano il fornitore dell'errore. [1]
Nel caso dashcam la slide della risposta attesa indica la versione vecchia come pertinente. La slide 9 rimanda alla successiva per dettagli delle versioni. È fuori dall'estratto pubblico di nove slide. Non forniamo quindi un conteggio di prodotti che hanno gestito correttamente la versione. [10] [4]
Quanto peso attribuire alle evidenze?
È un confronto reale circoscritto pubblicato dall'organizzatore. Offre evidenze più specifiche di un elenco funzionale. È anche una piccola fotografia di giugno e Weblaw gestisce Lawsearch AI partecipante. Segnaliamo il rapporto commerciale: un confronto dell'organizzatore ha statuto diverso da un benchmark indipendente riproducibile integralmente.
La copertina precisa che non tutti gli invitati hanno partecipato e che uno dei concorrenti ha rifiutato la riproduzione dei propri risultati. Non lo nomina. Non deducetelo dall'ordine dei loghi, colonne anonime o marketing altrui. [5]
La valutazione completa è gratuita su richiesta. Abbiamo usato l'estratto pubblico senza ottenere rapporto o output completi. Restano indisponibili risultati nominati, quarto caso completo e registrazione sufficiente per riprodurre. Un aggiornamento futuro conserva la data originale e distingue nuove evidenze dall'estratto. [1]
Whisperit, Swiss-Noxtua, CASUS e DeepJudge non sono partecipanti nominati. Non sono stati valutati in questo insieme; non significa zero punti, prestazioni scadenti o esclusione per un motivo particolare.
Trasformate la challenge in una prova migliore
Chiedete ai candidati un mandato con diritto storico noto. Data, versione e ragionamento transitorio devono essere espliciti. Fornite fonte contraria e chiedete se cambia la conclusione. Includete fatto deliberatamente assente e premiate domanda o limite dichiarato.
Per ogni affermazione sostanziale aprite il passaggio e registrate se la sostiene. Separate «esiste», «è pertinente» e «prova questa affermazione». Trasformate poi ricerca nella consegna necessaria e fate verificare a un altro avvocato.
Le matrici non accertano questo flusso finale. Dettatura, abbonamenti, modifica, architettura di riservatezza, passaggi e valore commerciale richiedono evidenze proprie. Il nostro foglio vuoto aggiunge controlli senza fingere misurazioni nell'evento.
Usate la panoramica svizzera per categorie e distinzioni attuali. La guida alla ricerca svizzera seleziona per fonti senza nominare un vincitore dalle matrici.
Domande frequenti
Quale prodotto ha vinto?
I materiali pubblici non accertano un vincitore nominato. Non assegneremo nomi alle colonne o fabbricheremo classifiche dalla lista dei partecipanti.
I dati scaricabili sono un benchmark indipendente?
No. È la trascrizione Whisperit dei fatti osservabili nelle slide pubbliche, conservando provenienza e valori mancanti. Le immagini restano collegate presso Weblaw; non abbiamo ripubblicato la presentazione.
Perché non calcolare percentuali o punteggio totale?
Trovare una decisione in sei colonne non è accuratezza generale 6/7 dei prodotti. Le metriche hanno significati diversi e dati non divulgati. Un composito nasconderebbe limiti e implicherebbe un confronto non sostenuto.
Romain de Wolff


